Wednesday, July 31, 2013

About TopHat accepted.bam

TopHat 의 align 결과 stats 를 뽑기 위해 samtools flagstat을 사용하려 한다. 관련된 내용을 정리한다.


http://www.biostars.org/p/12475/  참조
위 URL이 조금 설명이 잘못된 부분이 있어 아래와 같이 수정한다


<example>
아래 내용은 tophat에서 생성된 bam 파일을 samtools flagstat을 한 결과이다.

40578140 + 0 in total (QC-passed reads + QC-failed reads)  #bam파일에 recording 되어 있는 read 수
0 + 0 duplicates 
40578140 + 0 mapped (100.00%:nan%)  #tophat 자체는 mapping 된 read의 정보만 bam 파일을 만들기 때문에 bam 파일에 있는 read는 모두 mapping 된 것으로 100%가 나옴, 0x4가 없는 read
40578140 + 0 paired in sequencing  #paired-end sequencing, 0x1 을 갖는 read
20716091 + 0 read1  #bam 파일에서 read1의 갯수 #0x40을 갖은 read
19862049 + 0 read2  #bam 파일에서 read2의 갯수 #0x80을 갖은 read
14778858 + 0 properly paired (36.42%:nan%)  #read1과 read2가 같은 chromosome 에 적절한 방향성을 같고 align 이 제대로 된 경우, 0x2를 갖고 있는 read
31546712 + 0 with itself and mate mapped #pair이고 mate도 mapping이 됐지만 proper 하게 mapping이 안된경우, 0x1을 가지고 있으나 0x2는 없고 0x8도 없는 경우
9031428 + 0 singletons (22.26%:nan%) #read itself는 mapping이 됐지만 pair가 mapping이 안된 경우, 0x8을 가지고 있는 read
0 + 0 with mate mapped to a different chr
0 + 0 with mate mapped to a different chr (mapQ>=5)


결과적으로..
tophat의 align 결과인 accepted_hits.bam 파일은 multiple alignment option를 허용했을 때, 하나의 read에 대해 여러개의 record를 남긴다. samtools flagstat은 read의 flag 값만을 가지고 stat을 뽑는걸로 보이는데 그렇기 때문에 read가 중복 count 된다. 
이해가 안되는 것은 마직막 stats, "with mate mapped to a different chr" 은 왜  count 하지 않는냐는 것.


<SAM format flag>
16진수의 3자리의 수의 10진법으로 변환한 것이 flag이므로 3번째 자리의 숫자가 있는지 확인하기 위해서는 16^2 = 256 의 몫을 2번째 자리의 숫자를 확인하기 위해서는 16의 몫을 그리고 나머지가 1번째 자리의 수.

예)
163 = 16*10 + 3
에서 10 은 0x80 + 0x20 을 의미하고 3 은 0x1 + 0x2 를 의미

또한 각 bit 의 의미는 아래와 같음.
0x1  read paired
0x2  read mapped in proper pair
0x4  read unmapped
0x8  mate unmapped
0x10  read reverse strand
0x20  mate reverse strand
0x40  first in pair
0x80  second in pair
0x100  not primary alignment
0x200  read fails platform/vendor quality checks
0x400  read is PCR or optical duplicate

<Illumina sequence identifiers>
http://en.wikipedia.org/wiki/FASTQ_format 참조

한 샘플에 대해 여러 lane을 걸게 되면 하나의 fastq안에 서로 다른 lane number를 갖을 수 있음.

Wednesday, July 10, 2013

samtools pileup format

과거 포스팅을 보면..
http://graphy2111.blogspot.kr/2011/07/sanger-fastq-file-format-for-sequences.html


<conversion illumina 1.3+ quality ascii to phred score>

illumina 1.3+ fastq의 ascii를 quality로 바꿔주기 위해서는 
python의 경우)

  • ord('문자') - 64   # 64가 offset이기 때문에


<pileup format>
http://samtools.sourceforge.net/pileup.shtml

예)
  • seq1 272 T 24 ,.$.....,,.,.,...,,,.,..^+. <<<+;<<<<<<<<<<<=<;<;7<&
  • <chrmosome> <1-based coordinate> <reference base> <# of reads> <read bases> <base qualities>

<base qualities> :: 위 illumina phred score 확인.
<read bases> :: 
  • "." :: match to ref base on the forward strand
  • "," :: match to ref base on the reverse strand
  • "ACGTN" :: mismatch on the forward
  • "acgtn" :: mismatch on the reverse
  • "\+[0-9]+[ACGTNacgtn]+" :: 그 위치와 다음 위치의 base 사이에 insertion이 있음을 의미
  • "\-[0-9]+[ACGTNacgtn]+" :: 그 위치와 다음 위치의 base 사이에 deletion이 있음을 의미
  • "^" :: start of a read segment, "^" 뒤의 문자는 mapping quality를 나타내는 ascii code (-33 필요)
  • "$" :: end of a read
중요한건 insertion, deletion, start, end를 나타내는 기호 다음에는 반드시 ".", ",", "ACGTN", "acgtn" 가 나타난다.
예)
  • seq2 156 A 11 .$......+2AG.+2AG.+2AGGG <975;:<<<<<
  • (.)($.)(.)(.)(.)(.)(.)(+2AG.)(+2AG.)(+2AGG)(G) 를 의미함.
위에서 보면 +n 다음 나오는 n개의 BASE(혹은 character)는 insert 된 base를 나타내고 그 다음 base는 그 위치에서는 base에 대한 정보. 곧 +2AG. 이라 함은 2개의 base AG가 insertion 되었고 .은 그 위치에서 base가 reference와 동일하다를 의미

                     |  <===== 이 위치에서의 pileup을 생각해보면
reference :: AGTTCG--G
read      :: AGTTCGAGG

이는 +2AG. 으로 표현됨

Friday, May 10, 2013

odds ratio

이전 스터디 카페에 정리햇던 글인데 쉽게 찾을 수 있게 여기다 옮겨 놓는다...


23andMe white paper 를 이야기 하면서 나왔던 것 중의 하나인 odds ratio 설명을 좀더 와닿게 설명해보도록 하겠습니다(물론 저의 생각인지라 틀린 점이 있거나 혹은 별로 와닿지 않을 수도 있으며 이 경우 수정 답글을 달아 주시면 감사하겠습니다).

white paper 에서 처럼 genotype이 3종류 임을 가정하겠습니다 (G1,G2,G3 , 여기서 특정 trait D에 가장 좋은 genotype을 G1 이라고 가정합니다). D 는 disease 혹은 관심 있는 trait의 발변형이라고 하겠습니다.

먼저 odds 를 보자면 
odds(x) = Pr(x) / 1 - Pr(x) 이므로
odds(D|G2) = Pr(D|G2) / 1 - Pr(D|G2) 입니다.

여기서 분모를 보면 
1 - Pr(D|G2) = (Pr(G2) - Pr(D,G2)) / Pr(G2) = Pr(D',G2) / Pr(G2) = Pr(D'|G2) 가 됩니다 (D' 는 disease 가 아닌 표현형).

곧 odds(D|G2) = Pr(D|G2) / 1 - Pr(D|G2) = Pr(D|G2) / Pr(D'|G2) 가 되는 것이죠.

이 odds 수식을 말로 설명하자면 특정인의 genotype 이 G2 일때 질병 D 에 걸릴 확률이 안 걸릴 확률에 비해 odds(D|G2) 값 만큼 높다는 것입니다. 좀 더 구체적으로 수치로 예를 들자면 내가 genome 상의 특정 위치에서 genotype이 C 가 나왔는데 이로 인한 disease D의 odds가 3이 나왔다면 전 그 병인 D 에 걸릴 활률이 안 걸릴 확률보다 3배가 높은 것이죠.


odds ratio를 보자면 
odds ratio = odds(D|G2)/odds(D|G1) 입니다(white paper에서도 나왔듯이 odds ratio의 분모의 genotype은 항상 가장 odds가 낮은 genotype인 G1 이 되겠습니다).

마찬가지로 구체적인 수치로 예를 들자면 odds(D|G1)의 값이 0.5 라면 저의 genotype에 의한 odds ratio는 3/0.5 로 6이 되는 것입니다. 이는 가장 좋은 genotype을 갖은 사람에 비해서는 제가 disease D 에 걸릴 위험도가 6 배가 높다는 것입니다. 

Tuesday, April 23, 2013

PLINK

GWAS에 대한 전체 적인 윤곽을 잡고 세부적으로 필요한 내용을 정리하고자 한다. 접근 방법이 논문으로 하는 것이 일반적이기는 하나 여러 문제로 인하여 좀 더 와닿는 실용적인 방법으로 접근해 보려 한다. 한 방법은 application을 이용해 보면서 용어, 기법들을 숙지하는 것. 

PLINK에 대해 알아보자. 아래 내용은 http://pngu.mgh.harvard.edu/~purcell/plink/ 와 그 외의 필요한 자료를 정리한 것으로 한다.


PLINK tutorial (manual chapter 2) 

<<Abstract>>
89 Asian HapMap individuals 의 83,534 autosomal SNPs을 가지고 간략한 GWAS 분석(case-control GWAS)을 해본다(tutorial data download 필요). 
특정 관심 trait는 인종과 특정 SNP(rs2222162) 그리고 random component의 복합적인 효과로 만들어져있음을 가정한다.
trait와 인종, trait와 rs2222162와의 관계는 아래와 같다 (quantitative trait 는 특정 trait 에 대한 측정 값이 "qt.phe" 파일에 나타나 있고, 이 수치의 median 값인 6.828753를 기준으로 이 값보다 크면 case, 작으면 control로 구분하여 disease trait를 정하였다). 


 <population-disease table>

<rs2222162-disease table>

<<Input Data>>
PLINK의  input은 기본적으로 PED file과 MAP 파일이 있다.

  • MAP file : marker (SNP) 에 대한 설명 파일, 아래와 같은 4개의 column으로 구성
    • chromosome (1-22, X, Y, or 0 if unplaced)
    • rs# or snp identifier
    • Genetic distance (morgans)
    • Base-pair position (bp units)
  • PED file : 각 individual의 genotype 정보가 들어잇는 파일, 아래 6개 column은 의무적으로 들어가 있으며 그 뒤 genotype 의 column이 들어가게 된다.
    • Family ID
    • Individual ID
    • Paternal ID
    • Maternal ID
    • Sex (1= male; 2=female; other=unknown)
    • Phenotype

위 MAP, PED 파일과 두개의 phenotype file ( 위 table의 quantitative trait와 disease trait를 위한 파일, phe 확장자)이 이번 tutorial의 input이 되겠다.

  • phe file : phenotype을 나타내는 파일로 아래 3개의 column으로 구성됨
    • Family ID
    • Individual ID
    • trait value

<<Overview>>
이 tutorial 에서는 GWAS 의 아래와 같은 사항에 대해 test 해 본다.
  • getting started ;; 기본적인 명령어 사용법
  • making a binary PED file ;; PED 파일을 binary 파일인 BED 변환하여 빠른 PLINK 실행 도모
  • working with the binary PED file ;; BED 파일 사용법
  • summary statistics : missing rates ;; PED 파일의 간략한 서머리로 missing 된 SNP나 individual 의 
  • summary statistics : allele frequencies ;;
  • basic association analysis ;;
  • genotypic association models ;;
  • stratification analysis ;;
  • association analysis, accounting for clusters ;;
  • quantitative trait association analysis
  • extracting a SNP of interest ;;
위 사항 중 몇가지만 더 자세하게 알아본다.

<<Detail>>
-summary statistics-
기본적으로 PLINK에서는 분석에 앞서 SNP과 individual의 filtering을 하게 된다. MIND, GENO, MAF 의 3가지 옵션에 의해 filtering 이 되는데 MIND의 경우 individual을 filtering 하는데, GENO와 MAF는 SNP를 filtering 하는데 사용된다(default :: MIND>0.1, GENO > 0.1, MAF < 0.01). MIND는 individual의 missing SNP의 비율을 나타내고, GENO의 경우 한 SNP가 전체 population에서의 missing 된 비율을 나타내며, MAF는 minor allele frequency 를 의미한다. 그렇기 때문에 MIND와 GENO의 옵션의 경우 값이 클수록 loose 한 filtering이 되며 MAF의 경우 값이 작을 수록 loose 하게 된다.

-Basic Association Analysis-
plink --bfile hapmap1 --assoc --out as1 #bfile은 binary PED를 사용하라는 의미이고 --assoc는 association test를 하라는 의미
아래와 같은 결과 파일(as1.assoc) 생성
  • A1 : code for allele 1(the minor allele)
  • F_A : case (affected) 에서의 A1 frequency
  • F_U : control (unaffected) 에서의 A1 frequency
  • A2 : code for other allele
  • CHISQ : chi-squared statistic
  • P : asymptotic significance value
  • OR : odds ratio
<<command line>>
plink --file hapmap1
plink --file hapmap1 --make-bed --out hapmap1
plink --file hapmap1 --make-bed --mind 0.05 --out highgeno
plink --bfile hapmap1 --missing --out miss_stat
plink --bfile hapmap1 --chr 1 --out res1 --missing
plink --bfile hapmap1 --freq --out freq_stat
plink --bfile hapmap1 --freq --within pop.phe --out freq_stat
plink --bfile hapmap1 --snp rs1891905 --freq --within pop.phe --out snp1_freq_stat
plink --bfile hapmap1 --assoc --out as1
plink --bfile hapmap1 --assoc --adjust --out as2
plink --bfile hapmap1 --pheno pop.phe --assoc --adjust --out as3
plink --bfile hapmap1 --model --snp rs2222162 -out mod1
plink --bfile hapmap1 --model --cell 0 --snp rs2222162 --out mod2
plink --bfile hapmap1 --cluster --mc 2 --ppc 0.05 --out str1
plink --bfile hapmap1 --mh --within str1.cluster2 --adjust --out aac1
plink --bfile hapmap1 --cluster --cc --ppc 0.01 --out version2
plink --bfile hapmap1 --mh --within version2.cluster2 --adjust --out aac2
plink --bfile hapmap1 --cluster --K 2 --out version3
plink --bfile hapmap1 --mh --within pop.phe --adjust --out aac3
plink --bfile hapmap1 --cluster --matrix --out ibd_view
plink --bfile hapmap1 --assoc --pheno qt.phe --out quant1
plink --bfile hapmap1 --assoc --pheno qt.phe --perm --within str1.clulster2 --out quant2
plink --bfile hapmap1 --assoc --pheno qt.phe --mperm 1000 --within str1.cluster2 --out quant3
plink --bfile hapmap1 --pheno qt.phe --gxe --covar pop.phe --snp rs2222162 --out quant3
plink --bfile hapmap1 --snp rs2222162 --recodeAD --out rec_snp1

---------------------------------------------------------------------------------------------------
<<Additional Information>>
-chi-square test (Pearson's chi-squared test)- 
chi-square test는 expected frequency와 observed frequency에 차이가 있는 지를 검정하는 test.
observed frequency는 말 그대로 관측값을 의미. expected frequency를 구하는 방법은 두가지가 가능하다. 각 category 별로 균등하게 나누는 방법과 prior knowledge로 나누는 방법. 예를 들면 공대에 100명의 신입이 들어왔을 때 남여 의 expected frequency는 균등하게 50:50으로 예측할 수도 있고 혹은 작년의 기준 (prior knowledge)를 바탕으로 60:40 으로 예측할 수도 있다.
아래의 예로 chi-square test를 해본다(Thai 라는 자동차 딜러가 자동차 제고를 줄이기 위해 자동차 색깔의 판매수에 대해 자신의 예측과 실제 자동차 판매 댓수의 차이를 검정한다).
 위의 expected frequency는 20:30:10:10:30 의 prior knowledge(작년 판매수)를 기반으로 했다.
이 두 데이터가 실제로 차이가 있는 것인지 혹은 단순 observed frequency의 random sampling에 의한 것인지 판단하기 위해 chi-square test를 하게 된다. 이때 null hypothesis는 "차이가 없다"이며 alternative hypothesis는 "차이가 있다"가 된다. 아래 식 대로 chi-square statistic 을 구하게 되고 이 값의 chi-square distribution에 위치에 따라 차이가 유의함을 판단하게 된다.
 위 공식대로 계산하면 아래와 같은 값을 얻게 된다.

chi-square statistic이 26.95 임을 계산하게 되고 위 분포는 4 df (N-1 degree; 여기서 N은 color의 갯수) 의 chi-square distribution을 따른다고 가정하게 되므로 P=0.05 로 하였을때 chi-statistic, 9.49 보다 크게 되므로 null hypothesis를 reject 하게 된다. 곧 이 차이는 유의하다고 판단하게 된다.

http://www.enviroliteracy.org/pdf/materials/1210.pdf : chi-square 설명
http://acb.qfab.org/acb/ws09/presentations/Day3_JStankovich.pdf : chi-square, odd ratio 설명

Friday, April 27, 2012

Using Excel for Bioinformatics Data: Five Issues, Five Solutions

아래 링크는 5AM이라는 bioinformatics 회사에서 제공한 white paper로 생물학자들이 데이터를 분석하는데  excel을 많이 애용하는데, 이때 주의해야 할 점을 요약해 놓았다.


http://info.5amsolutions.com/bid/120220/Using-Excel-for-Bioinformatics-Data-Five-Issues-Five-Solutions


1. Manipulation of Gene Symbols

  • issue : 사용자가 넣어주는 데이터를 보고 excel이 알아서 formatting 을 한다는것. 예를 들어 SEP5 나 DEC-2 같은 경우 excel이 날짜 데이터로 인식하고 5-SEP, 2-DEC로 변경한다.
  • solution : 
    1. excel로 파일을 import 하기 전에 파일을 처리 할 수 있다면 gene symbol에 space나 apostrophe ( ' ) 를 넣어서 excel이 text 로 인식하게끔 한다.
    2. import wizard (그러니까 데이터를 import 할때 뜨는 팝업창 같은거) 에서 컬럼 서식을 "general" 대신 "text" 로 변경해준다.
2. The Incomplete Sort
  • issue : excel sheet의 일부 컬럼만 영역으로 선택해서 sorting 하게 되면 가끔 spreadsheet corruption 이 일어난다. 특히나 컬럼을 hidden 했을땐 이런 일이 종종 일어난다. 물론 대부분 excel이 컬럼 영역을 확장할 것인가를 물어보지만 물어보지 않을때도 있다.
  • solution : spread sheet 의 왼쪽 상단을 눌러서 전체 영역을 선택하는 습관을 가져라
3. Hidden Characters
  • issue : 웹에서 혹은 문서에서 특정 영역을 카피해다가 excel에 paste 하면 hidden character가 딸려 들어가서 특정 formula를 사용해서 에러가 날 때 까지 인지를 못할 경우가 발생
  • solution : excel이 TRIM and CLEAN data를 위한 formulas를 제공한다. 아니면 notepad 같은 걸로 거쳐서 거기서 다시 copy해서 excel로 옮기면 된다.
4. Information Through Formats
  • 이건은 생략한다. 딱히 뭐가 문젠지.. 굳이 이야기 하자면 글자색같은 format으로 정보를 넣으면 나중에 sorting  할때 혹은 그냥 text로 저장할때 그 색깔에 넣은 정보가 고스란히 날라간다는 문제점을 이야기 하는건데.. 주의하자는 거다.
5. Mistaken SYLK Files
  • issue : excel에서 text 파일의 첫 두 문자가 ID 이면 자동으로 SYLK(symbolic link 파일) 로 인식해서 에러 메시지를 낸다.
  • solution : ID 대문자를 id 소문자로 변환해도 이런 에러를 피할수 있으며 혹은 apostrophe 를 붙이거나 아니면 그 컬럼의 위치를 다른 곳으로 바꾼다.

Wednesday, April 4, 2012

python extension

tabix 를 python으로 importing 하기 위한 장혜식님의 c 코드를 이해하기 위해 필요한 것들을 정리 해본다.

일단 compiled language 로 작성된 code를 python에서 import 하기 위해선 "extension" 시켜야 하는데 이에 대한 기본적인 내용은 아래 사이트에서 찾아볼 수 있다.

<python - Further Extension using C>


<.so 와 .dll>
한빛 미디어에서 나온 유닉스,리눅스 프로그래밍 필수 유틸리티 gcc 부분 참조

Wednesday, March 28, 2012

knou 통계학 개론 4

제 8장 회귀분석


상관분석(correlation analysis) : 관련있는 두 변수간의 관련성을 통계적으로 분석하는 것으로 본격적으로 두 변수의 관련성을 가지고 회귀분석에 들어가기 전에 자료를 정비하는 것

상관분석의 단계
  1. 두 변수간의 상관성을 눈으로 산점도 작성
  2. 두 변수간의 상관성을 수치화
  3. 상관계수가 통계적으로 유효한지 검정
1. 산점도 작성
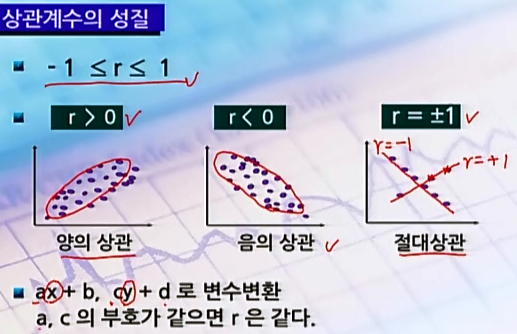
  1. 상관관계의 종류 : 양의 관계, 음의 관계, 무 관계, 곡선 관계(예를 들어 양의 상관관계였다가 음의 상관관계로 변하는 관계), 절대 상관 관계(완벽하게 직선상에 데이터 있는 경우)
  2. 이상점(outlier)를 발견 가능
  3. 층별 을 이루는가를 확인 할 수 있다(층별이 관측되었을 때 분리해서 분석을 해야 하지 않나라고 판단할 수 있다). 
2. 상관 관계의 수치화 
  • 상관계수(correlation coefficient) : 두 변수의 관계를 하나의 수치로 나타낸 척도
  • r= 0 이라고 해서 꼭 무상관은 아니다. 곡선 관계일수도 있기 때문에 꼭 산점도를 그래서 확인하는 것이 좋다. 그리고 이상치의 유무를 확인하기 위해서도 산점도는 필요하다.
혼돈요인(confounding factor) : 숨은 변수. 이 변수를 놓치면 분석시 잘못된 결론을 내릴 수 있다.

심슨 파라독스(Simpson's Paradox) : 자료분석 시 숨은 변수, 컨파운딩 팩터를 놏치면 반대의 결론을 내게 됨, 예를 들어 학생들의 전체를 놓고 분석했을때 tv 시청과 읽기 능력의 양의 상관관계가 있는 것처럼 보였으나 학년 별로 그룹핑을 해서 상관분석을 해보니 학년 내에서는 음의 상관관계가 있는 것으로 나타났다.

3. 상관계수의 유의점 점검