Sunday, August 4, 2013

coursera Computational Molecular Evolution

coursera 의 6주 과정수업으로 이번주에 종강을 하게 되는데 정리를 해보고자 한다.
https://class.coursera.org/molevol-001/class/index

https://spark-public.s3.amazonaws.com/molevol/Downloads/slides_week1.pdf 
... (1~6 까지)

아래 내용은 단순히 위 URL의 vod를 요약한 것으로 추가적인 자료 확인이나 이해를 높이기 위한 노력이 없었으므로 잘못된 해석이 들어가 있을 수 있다.

또한 강의 초반의 classification, evolution, selection, genetic drift, phylogenetic tree teminology 등은 생략한다.  

molecular data, 즉 DNA sequence로 부터 어떻게 phylogenetic tree를 구축하는지 알아본다.
<Maximum Parsimony>
simplest possible hypothesis를 선택하는 것이 maximum parsimony 방식. 곧 shortest tree(데이터를 나타내는데 필요한 mutation 갯수가 가작 적은 tree) 를 선택하는 방식.

오른쪽 테이블(4개 샘플 A,B,C,D의 sequence (3bp로 구성)를 multiple alignment 한 결과)를 예를 들어 보면 1번 bp를 기준으로 보면 왼쪽의 두개의 phylogenetic tree 중 위의 tree가 단 하나의 mutation 만 필요하므로 데이터를 잘 나타내는 tree 라고 판단하는 것이다.


위의 tree는 3개의 bp를 모두 고려 했을때의 tree length를 나타낸 것으로 위의 maximum parsimony의 방식으로는 tree가 적당한 tree로 판단된다.

다르게 표현하면 maximum parsimony는 homoplasy가 가장 적게 나타나는 tree를 선택하는 것이다.
homoplasy는 위의 그림에서 보듯이 공통의 조상으로 부터 얻은 형질이 아니라 각기 따로 얻은 형질이 비슷한 것을 의미하는 것. shortest tree를 선택하게 되어 있는 maximum parsimony는 mutation 갯수를 줄이는 방향으로 tree를 선택하므로 동일한 서열은 공통의 조상으로 부터 오게끔 샘플을 배치하기 때문에 homoplasy가 적은 tree를 선택하게 되는 것.

그러면 DNA 데이터로 부터 어떻게 maximum parsimony tree를 찾을까? (이 수업에서는 DNA의 multiple alignment에 대해서는 설명하지 않음)
아래와 같은 순서대로 parsiminious tree를 찾음

1. Construct list of all possible trees for data set
2. For each tree: determine length, add to list of lengths
3. When finished: select tree from list
4. If several trees have the same length, then they are equally good (equally parsimonious)

tree를 construction 하는 방법은 아래와 같다(이 같은 방식을 exhaustive search 라고 함, 모든 tree를 다 찾는 방식).
먼저 radom 하게 3개의 샘플을 뽑고 tree를 구성(3개 샘플에서는 unroot tree 일때 딱 하나의 tree밖에 나올수 없다). 그 뒤 모든 가능한 branch 에다가 새로운 샘플을 끼어 넣음.

tree가 구축되었으면 그 다음 tree length를 구하는 방법이 필요. 그것이 fitch algorithm.
<The Fitch Algorithm>
1. Root the tree at an arbitrary internal node (or internal branch)
2. Visit an internal node x for which no state set has been defined, but where the state sets of x's immediate descentdants (y,z) have been defined
3. If the state sets of y,z have common states, then union of y,z to x, and increase tree length by one
4. Repeat until all internal nodes have been visited. Note length of current tree.
위 그림이 tree length 를 구하는 예. 각 leaf는 샘플의 DNA 서열을 나타냄. unrooted tree 에서 internal branch를 끌어서 rooted tree를 생성. 그뒤 leaf 에부터 internal node를 정하면서 length 를 결정.

모든 tree를 다 구축해보는 것은 현실적으로 불가능. 이에 대한 방안을 알아본다.
<Searching Tree Space>
exhaustive search는 엄청나게 많은 tree를 생성하게 된다(위의 exhaustive search의 그림과 아래 table 참고).

그 대안으로 나온것이 Branch and bound 방식. 랜덤하게 tree 하나를 뽑아서 그것의 length를 구하고 그것을 기준으로 삼는것. 그래서 tree construction 할때 그 기준보다 넘어가버리면 아예 그것과 관련된 tree는 더이상 계산하지 않는 것이다.

위 그림의 오른쪽 상단의 것을 기준으로 삼으면 tree를 construction 할때 두번째 layer의 오른쪽과 왼쪽의 tree는 이미 기준의 tree보다 length가 길기 때문에 더이상 샘플을 adding 하지 않는다.
하지만 branch and bound 역시 샘플 수가 많으면 효과적인 방법이 아님.
그래서 나온방식이 Heuristic search.
1.Construct initial tree (e.g.,sequential addition); determine length
2. Construct set of "neighboring trees" by making small rearrangements of initial tree; determine lengths
3.If any of the neighboring trees are better than the initial tree, then select it/them and use as starting point for new round of rearrangements (possibly several neighbors are equally good)
4. Repeat steps 2+3 until you have found a tree that is better than all of its neighbors
5. This tree is a "local optimum" (not necessarily a global optimum)

랜덤하게 tree 하나 뽑아서 length 구하고 이 tree의 rearrangement 해서 length를 구하고 이 새로운 tree가 기존의 tree 보다 length가 짧아지면 이 tree로 갈아타서 또 rearrange 하고.. 이를 반복해서 local optimum을 찾는것. 곧 경험적으로 해봐서 더이사 좋아지지 않는다 싶으면 멈추는 것을 의미.

tree의 rearrangement는 아래와 같이 3가지 방식이 있다. TBR > SPR > NNI


maximum parsimony 같은 방법을 이용하면 equally parsimonious 한 tree들이 많이 찾아지게 된다. 이때 어떻게 해야 하는가? 여기서 어떠한 정보를 뽑아 낼 수 있는가?
<consensus tree>
설령 수많은 equally parsimonious trees 가 찾아졌다 하더라도 실상 tree들의 전체 적인 형태는 비슷하며 단지 약간의 차이가 있을 뿐이다. 그렇기 때문에 consensus tree를 구축함으로써 tree set으로부터 정보를 뽑아 낼수 있다.
위와 같이 strict consensus tree는 모호한 부분은 polytomy를 이용하여 나타내는 방법 (첫번째와 두번째 tree는 동일한데, 어떻게 동일한 tree가 두번 나올수 있냐에 대해서는 저 tree들이 더 큰 tree의 subtree라고 가정해보면 됨).

두번째 방법으로는 majority rule consensus tree. 다수의 tree를 따르는 것.

majority consensus tree를 구축하는 방법
1. tree set의 tree 하나씩 모든 internal branch를 기준으로 bipartition으로 해서 나타나는 separation을 table로 정리한다.
2. 정리되 table을 count를 frequency로 바꾼뒤 ordering 해서 50이상의 값을 갖는 separation을 찾는다.
위의 그림처럼 6개의 equally parsimonious trees 가 있을 때 tree 하나씩 모든 internal node 를 기준으로 두 그룹으로 나눈다. 이때 두 그룹이 몇번 나왓는가를 오른쪽 table 처럼 정리한다(분홍색 branch를 기준으로 A,E 와 C,B,D,F 가 나뉘는데 갯수가 적은 group을 *로 표시하고 많은 group은 -으로 표시하면 오른쪽 테이블과 같이 표시 할 수 있다).
 최종적으로 모든 tree의 internal branch로 bipartition을 한 결과 위의 그림과 같은 count table를 구할 수 있다. 그리고 이 count를 전체 tree의 갯수로 나눈 뒤 ordering을 한다. 이후아래 그림과 같이 50 % 가 넘는 record를 가지고 majority consensus tree를 만든다.
50 이상의 record를 가지고 tree를 구축하였으므로 반드시 50 이상의 record들은 comparable 하게 표현이 된다(절반 이상의 tree들이 그러한 특성을 갖은 것이므로 ).

maximum parsimony 이외에 DNA data를 잘 나타내는 phylogenetic tree를 찾는 방법을 알아본다.
<Distance Matrix Method>
위의 그림과 같이 DNA를 multiple alignment 하고 나서 distance matrix(숫자는 different base의 갯수)를 만든 다음 이 matrix를 만족시키는 tree를 구축하는 방법이 distance matrix method.
distance matrix method 는 DNA alignment를 해 놓고 DNA different count인 observed distance의 값을 가장 잘 나타내는 phylogenetic tree를 구축하는 것 목표(위의 그림에서 D값과 d 값의 차이가 가장 작게 하는게 목표).
observed distance(D)와 phylogenetics tree의 distance(d)의 차이는 sum of squares(Q)로 표현 가능하다. 이때 일반적으로 distance가 멀수록 error가 더 들어 가기 때문에 D의 n차로 나누어 보정한다.
 위의 예가 sum of square(Q)를 계산한 식이다. 위의 식을 아래와 같이 각 branch의 길이의 이차 함수로 표현이 되고 이차 함수는 아래로 볼록한 형태를 갖고 있으며 최소값은 미분했을때 0인 값이므로 아래와 같이 각 branch의 길이가 결정된다.
이 때 이 Q값이 가장 작은 tree를 선택하게 되면 이는 Least Squares Optimality Criterion에 의한 것이고 branch의 합이 가장 작은 tree를 선택하는 것이 Minimum Evolution Optimality Criterion 에 의한 것이다(두 방식다 tree의 branch를 결정할때는 sum of square를 이용하고 최종적으로 가장 적절한 tree가 뭔가를 선택할때 기준이 달라진다).


distance matrix method 역시 parsimony와 같이 tree를 만들어 놓고 평가하는 방식이다. 그렇기 때문에 tree가 많아지면 exhaustive method 방식보다는 heuristic algorithm을 이용하여 효율을 높일 수 있다. distance matrix method의 경우 이 외에도 clustering algorithm 을 이용할 수 있는데 그 한 방법인 neighbor joining 방법을 알아본다.
Neighbor Joining(NJ) Agorithm
알고리즘은 아래와 같다.
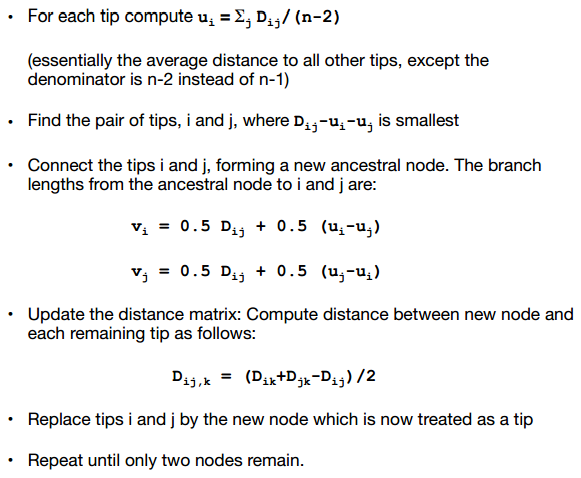
아래 그림은 NJ의 한예이다. 아래 그림의 왼쪽 상단의 table과 같이 distance matrix가 주어졌다고 할때 오른쪽 상단의 table과 같이 u 값을 계산한다. 그 뒤 왼쪽 하단과 같은 새로운 distance matrix를 생성하고 이 값중 제일 작은 값을 갖는 pair를 찾는다(-39가 가장 작은 값으로 A,B 와 C,D가 있는데 여기서는 C,D를 선택). 그뒤 오른쪽 하단과 같이 새로운 노드 X와 C,D의 거리를 구한다.
C와 D가 clustering 되어 새로운 노드 X를 생성한 뒤 아래 그림과 같이 새로운 X 노드와 나머지 노드 간의 거리를 구해야 한다.
C,D의 record는 삭제한 뒤 A,B,X 만 가지고 위 과정을 반복한다. 최종적으로 아래와 같은 그림으로 완성


-----------------------------------------------------------------
%정리를 하자면 tree를 구축하는 방식은 exhaustive, branch and bound, 그리고 heuristic  방식이 있는 것. 그리고 그 tree를 평가 하는 방식으로 maximum parsimony, distance matrix method가 있는 것. maximum parsimony의 경우 fitch algorithm으로 계산 가능하고, distance matrix의 경우 tree 선택 기준에 least squares 와 minimum evolution 방식으로 나눌 수 있다.
추가적으로 matrix distance method의 경우에는 clustering 방식으로 optimal tree를 결정할 수 있는데 NJ(neighbor joining algorithm)이 그 한 방법이다. NJ 방법은 distance matrix에서 가장 짧은 노드를 합치는 식으로 step-by-step으로 phylogenetic tree를 구축하는 방법이다.

Wednesday, July 31, 2013

About TopHat accepted.bam

TopHat 의 align 결과 stats 를 뽑기 위해 samtools flagstat을 사용하려 한다. 관련된 내용을 정리한다.


http://www.biostars.org/p/12475/  참조
위 URL이 조금 설명이 잘못된 부분이 있어 아래와 같이 수정한다


<example>
아래 내용은 tophat에서 생성된 bam 파일을 samtools flagstat을 한 결과이다.

40578140 + 0 in total (QC-passed reads + QC-failed reads)  #bam파일에 recording 되어 있는 read 수
0 + 0 duplicates 
40578140 + 0 mapped (100.00%:nan%)  #tophat 자체는 mapping 된 read의 정보만 bam 파일을 만들기 때문에 bam 파일에 있는 read는 모두 mapping 된 것으로 100%가 나옴, 0x4가 없는 read
40578140 + 0 paired in sequencing  #paired-end sequencing, 0x1 을 갖는 read
20716091 + 0 read1  #bam 파일에서 read1의 갯수 #0x40을 갖은 read
19862049 + 0 read2  #bam 파일에서 read2의 갯수 #0x80을 갖은 read
14778858 + 0 properly paired (36.42%:nan%)  #read1과 read2가 같은 chromosome 에 적절한 방향성을 같고 align 이 제대로 된 경우, 0x2를 갖고 있는 read
31546712 + 0 with itself and mate mapped #pair이고 mate도 mapping이 됐지만 proper 하게 mapping이 안된경우, 0x1을 가지고 있으나 0x2는 없고 0x8도 없는 경우
9031428 + 0 singletons (22.26%:nan%) #read itself는 mapping이 됐지만 pair가 mapping이 안된 경우, 0x8을 가지고 있는 read
0 + 0 with mate mapped to a different chr
0 + 0 with mate mapped to a different chr (mapQ>=5)


결과적으로..
tophat의 align 결과인 accepted_hits.bam 파일은 multiple alignment option를 허용했을 때, 하나의 read에 대해 여러개의 record를 남긴다. samtools flagstat은 read의 flag 값만을 가지고 stat을 뽑는걸로 보이는데 그렇기 때문에 read가 중복 count 된다. 
이해가 안되는 것은 마직막 stats, "with mate mapped to a different chr" 은 왜  count 하지 않는냐는 것.


<SAM format flag>
16진수의 3자리의 수의 10진법으로 변환한 것이 flag이므로 3번째 자리의 숫자가 있는지 확인하기 위해서는 16^2 = 256 의 몫을 2번째 자리의 숫자를 확인하기 위해서는 16의 몫을 그리고 나머지가 1번째 자리의 수.

예)
163 = 16*10 + 3
에서 10 은 0x80 + 0x20 을 의미하고 3 은 0x1 + 0x2 를 의미

또한 각 bit 의 의미는 아래와 같음.
0x1  read paired
0x2  read mapped in proper pair
0x4  read unmapped
0x8  mate unmapped
0x10  read reverse strand
0x20  mate reverse strand
0x40  first in pair
0x80  second in pair
0x100  not primary alignment
0x200  read fails platform/vendor quality checks
0x400  read is PCR or optical duplicate

<Illumina sequence identifiers>
http://en.wikipedia.org/wiki/FASTQ_format 참조

한 샘플에 대해 여러 lane을 걸게 되면 하나의 fastq안에 서로 다른 lane number를 갖을 수 있음.

Wednesday, July 10, 2013

samtools pileup format

과거 포스팅을 보면..
http://graphy2111.blogspot.kr/2011/07/sanger-fastq-file-format-for-sequences.html


<conversion illumina 1.3+ quality ascii to phred score>

illumina 1.3+ fastq의 ascii를 quality로 바꿔주기 위해서는 
python의 경우)

  • ord('문자') - 64   # 64가 offset이기 때문에


<pileup format>
http://samtools.sourceforge.net/pileup.shtml

예)
  • seq1 272 T 24 ,.$.....,,.,.,...,,,.,..^+. <<<+;<<<<<<<<<<<=<;<;7<&
  • <chrmosome> <1-based coordinate> <reference base> <# of reads> <read bases> <base qualities>

<base qualities> :: 위 illumina phred score 확인.
<read bases> :: 
  • "." :: match to ref base on the forward strand
  • "," :: match to ref base on the reverse strand
  • "ACGTN" :: mismatch on the forward
  • "acgtn" :: mismatch on the reverse
  • "\+[0-9]+[ACGTNacgtn]+" :: 그 위치와 다음 위치의 base 사이에 insertion이 있음을 의미
  • "\-[0-9]+[ACGTNacgtn]+" :: 그 위치와 다음 위치의 base 사이에 deletion이 있음을 의미
  • "^" :: start of a read segment, "^" 뒤의 문자는 mapping quality를 나타내는 ascii code (-33 필요)
  • "$" :: end of a read
중요한건 insertion, deletion, start, end를 나타내는 기호 다음에는 반드시 ".", ",", "ACGTN", "acgtn" 가 나타난다.
예)
  • seq2 156 A 11 .$......+2AG.+2AG.+2AGGG <975;:<<<<<
  • (.)($.)(.)(.)(.)(.)(.)(+2AG.)(+2AG.)(+2AGG)(G) 를 의미함.
위에서 보면 +n 다음 나오는 n개의 BASE(혹은 character)는 insert 된 base를 나타내고 그 다음 base는 그 위치에서는 base에 대한 정보. 곧 +2AG. 이라 함은 2개의 base AG가 insertion 되었고 .은 그 위치에서 base가 reference와 동일하다를 의미

                     |  <===== 이 위치에서의 pileup을 생각해보면
reference :: AGTTCG--G
read      :: AGTTCGAGG

이는 +2AG. 으로 표현됨

Friday, May 10, 2013

odds ratio

이전 스터디 카페에 정리햇던 글인데 쉽게 찾을 수 있게 여기다 옮겨 놓는다...


23andMe white paper 를 이야기 하면서 나왔던 것 중의 하나인 odds ratio 설명을 좀더 와닿게 설명해보도록 하겠습니다(물론 저의 생각인지라 틀린 점이 있거나 혹은 별로 와닿지 않을 수도 있으며 이 경우 수정 답글을 달아 주시면 감사하겠습니다).

white paper 에서 처럼 genotype이 3종류 임을 가정하겠습니다 (G1,G2,G3 , 여기서 특정 trait D에 가장 좋은 genotype을 G1 이라고 가정합니다). D 는 disease 혹은 관심 있는 trait의 발변형이라고 하겠습니다.

먼저 odds 를 보자면 
odds(x) = Pr(x) / 1 - Pr(x) 이므로
odds(D|G2) = Pr(D|G2) / 1 - Pr(D|G2) 입니다.

여기서 분모를 보면 
1 - Pr(D|G2) = (Pr(G2) - Pr(D,G2)) / Pr(G2) = Pr(D',G2) / Pr(G2) = Pr(D'|G2) 가 됩니다 (D' 는 disease 가 아닌 표현형).

곧 odds(D|G2) = Pr(D|G2) / 1 - Pr(D|G2) = Pr(D|G2) / Pr(D'|G2) 가 되는 것이죠.

이 odds 수식을 말로 설명하자면 특정인의 genotype 이 G2 일때 질병 D 에 걸릴 확률이 안 걸릴 확률에 비해 odds(D|G2) 값 만큼 높다는 것입니다. 좀 더 구체적으로 수치로 예를 들자면 내가 genome 상의 특정 위치에서 genotype이 C 가 나왔는데 이로 인한 disease D의 odds가 3이 나왔다면 전 그 병인 D 에 걸릴 활률이 안 걸릴 확률보다 3배가 높은 것이죠.


odds ratio를 보자면 
odds ratio = odds(D|G2)/odds(D|G1) 입니다(white paper에서도 나왔듯이 odds ratio의 분모의 genotype은 항상 가장 odds가 낮은 genotype인 G1 이 되겠습니다).

마찬가지로 구체적인 수치로 예를 들자면 odds(D|G1)의 값이 0.5 라면 저의 genotype에 의한 odds ratio는 3/0.5 로 6이 되는 것입니다. 이는 가장 좋은 genotype을 갖은 사람에 비해서는 제가 disease D 에 걸릴 위험도가 6 배가 높다는 것입니다. 

Tuesday, April 23, 2013

PLINK

GWAS에 대한 전체 적인 윤곽을 잡고 세부적으로 필요한 내용을 정리하고자 한다. 접근 방법이 논문으로 하는 것이 일반적이기는 하나 여러 문제로 인하여 좀 더 와닿는 실용적인 방법으로 접근해 보려 한다. 한 방법은 application을 이용해 보면서 용어, 기법들을 숙지하는 것. 

PLINK에 대해 알아보자. 아래 내용은 http://pngu.mgh.harvard.edu/~purcell/plink/ 와 그 외의 필요한 자료를 정리한 것으로 한다.


PLINK tutorial (manual chapter 2) 

<<Abstract>>
89 Asian HapMap individuals 의 83,534 autosomal SNPs을 가지고 간략한 GWAS 분석(case-control GWAS)을 해본다(tutorial data download 필요). 
특정 관심 trait는 인종과 특정 SNP(rs2222162) 그리고 random component의 복합적인 효과로 만들어져있음을 가정한다.
trait와 인종, trait와 rs2222162와의 관계는 아래와 같다 (quantitative trait 는 특정 trait 에 대한 측정 값이 "qt.phe" 파일에 나타나 있고, 이 수치의 median 값인 6.828753를 기준으로 이 값보다 크면 case, 작으면 control로 구분하여 disease trait를 정하였다). 


 <population-disease table>

<rs2222162-disease table>

<<Input Data>>
PLINK의  input은 기본적으로 PED file과 MAP 파일이 있다.

  • MAP file : marker (SNP) 에 대한 설명 파일, 아래와 같은 4개의 column으로 구성
    • chromosome (1-22, X, Y, or 0 if unplaced)
    • rs# or snp identifier
    • Genetic distance (morgans)
    • Base-pair position (bp units)
  • PED file : 각 individual의 genotype 정보가 들어잇는 파일, 아래 6개 column은 의무적으로 들어가 있으며 그 뒤 genotype 의 column이 들어가게 된다.
    • Family ID
    • Individual ID
    • Paternal ID
    • Maternal ID
    • Sex (1= male; 2=female; other=unknown)
    • Phenotype

위 MAP, PED 파일과 두개의 phenotype file ( 위 table의 quantitative trait와 disease trait를 위한 파일, phe 확장자)이 이번 tutorial의 input이 되겠다.

  • phe file : phenotype을 나타내는 파일로 아래 3개의 column으로 구성됨
    • Family ID
    • Individual ID
    • trait value

<<Overview>>
이 tutorial 에서는 GWAS 의 아래와 같은 사항에 대해 test 해 본다.
  • getting started ;; 기본적인 명령어 사용법
  • making a binary PED file ;; PED 파일을 binary 파일인 BED 변환하여 빠른 PLINK 실행 도모
  • working with the binary PED file ;; BED 파일 사용법
  • summary statistics : missing rates ;; PED 파일의 간략한 서머리로 missing 된 SNP나 individual 의 
  • summary statistics : allele frequencies ;;
  • basic association analysis ;;
  • genotypic association models ;;
  • stratification analysis ;;
  • association analysis, accounting for clusters ;;
  • quantitative trait association analysis
  • extracting a SNP of interest ;;
위 사항 중 몇가지만 더 자세하게 알아본다.

<<Detail>>
-summary statistics-
기본적으로 PLINK에서는 분석에 앞서 SNP과 individual의 filtering을 하게 된다. MIND, GENO, MAF 의 3가지 옵션에 의해 filtering 이 되는데 MIND의 경우 individual을 filtering 하는데, GENO와 MAF는 SNP를 filtering 하는데 사용된다(default :: MIND>0.1, GENO > 0.1, MAF < 0.01). MIND는 individual의 missing SNP의 비율을 나타내고, GENO의 경우 한 SNP가 전체 population에서의 missing 된 비율을 나타내며, MAF는 minor allele frequency 를 의미한다. 그렇기 때문에 MIND와 GENO의 옵션의 경우 값이 클수록 loose 한 filtering이 되며 MAF의 경우 값이 작을 수록 loose 하게 된다.

-Basic Association Analysis-
plink --bfile hapmap1 --assoc --out as1 #bfile은 binary PED를 사용하라는 의미이고 --assoc는 association test를 하라는 의미
아래와 같은 결과 파일(as1.assoc) 생성
  • A1 : code for allele 1(the minor allele)
  • F_A : case (affected) 에서의 A1 frequency
  • F_U : control (unaffected) 에서의 A1 frequency
  • A2 : code for other allele
  • CHISQ : chi-squared statistic
  • P : asymptotic significance value
  • OR : odds ratio
<<command line>>
plink --file hapmap1
plink --file hapmap1 --make-bed --out hapmap1
plink --file hapmap1 --make-bed --mind 0.05 --out highgeno
plink --bfile hapmap1 --missing --out miss_stat
plink --bfile hapmap1 --chr 1 --out res1 --missing
plink --bfile hapmap1 --freq --out freq_stat
plink --bfile hapmap1 --freq --within pop.phe --out freq_stat
plink --bfile hapmap1 --snp rs1891905 --freq --within pop.phe --out snp1_freq_stat
plink --bfile hapmap1 --assoc --out as1
plink --bfile hapmap1 --assoc --adjust --out as2
plink --bfile hapmap1 --pheno pop.phe --assoc --adjust --out as3
plink --bfile hapmap1 --model --snp rs2222162 -out mod1
plink --bfile hapmap1 --model --cell 0 --snp rs2222162 --out mod2
plink --bfile hapmap1 --cluster --mc 2 --ppc 0.05 --out str1
plink --bfile hapmap1 --mh --within str1.cluster2 --adjust --out aac1
plink --bfile hapmap1 --cluster --cc --ppc 0.01 --out version2
plink --bfile hapmap1 --mh --within version2.cluster2 --adjust --out aac2
plink --bfile hapmap1 --cluster --K 2 --out version3
plink --bfile hapmap1 --mh --within pop.phe --adjust --out aac3
plink --bfile hapmap1 --cluster --matrix --out ibd_view
plink --bfile hapmap1 --assoc --pheno qt.phe --out quant1
plink --bfile hapmap1 --assoc --pheno qt.phe --perm --within str1.clulster2 --out quant2
plink --bfile hapmap1 --assoc --pheno qt.phe --mperm 1000 --within str1.cluster2 --out quant3
plink --bfile hapmap1 --pheno qt.phe --gxe --covar pop.phe --snp rs2222162 --out quant3
plink --bfile hapmap1 --snp rs2222162 --recodeAD --out rec_snp1

---------------------------------------------------------------------------------------------------
<<Additional Information>>
-chi-square test (Pearson's chi-squared test)- 
chi-square test는 expected frequency와 observed frequency에 차이가 있는 지를 검정하는 test.
observed frequency는 말 그대로 관측값을 의미. expected frequency를 구하는 방법은 두가지가 가능하다. 각 category 별로 균등하게 나누는 방법과 prior knowledge로 나누는 방법. 예를 들면 공대에 100명의 신입이 들어왔을 때 남여 의 expected frequency는 균등하게 50:50으로 예측할 수도 있고 혹은 작년의 기준 (prior knowledge)를 바탕으로 60:40 으로 예측할 수도 있다.
아래의 예로 chi-square test를 해본다(Thai 라는 자동차 딜러가 자동차 제고를 줄이기 위해 자동차 색깔의 판매수에 대해 자신의 예측과 실제 자동차 판매 댓수의 차이를 검정한다).
 위의 expected frequency는 20:30:10:10:30 의 prior knowledge(작년 판매수)를 기반으로 했다.
이 두 데이터가 실제로 차이가 있는 것인지 혹은 단순 observed frequency의 random sampling에 의한 것인지 판단하기 위해 chi-square test를 하게 된다. 이때 null hypothesis는 "차이가 없다"이며 alternative hypothesis는 "차이가 있다"가 된다. 아래 식 대로 chi-square statistic 을 구하게 되고 이 값의 chi-square distribution에 위치에 따라 차이가 유의함을 판단하게 된다.
 위 공식대로 계산하면 아래와 같은 값을 얻게 된다.

chi-square statistic이 26.95 임을 계산하게 되고 위 분포는 4 df (N-1 degree; 여기서 N은 color의 갯수) 의 chi-square distribution을 따른다고 가정하게 되므로 P=0.05 로 하였을때 chi-statistic, 9.49 보다 크게 되므로 null hypothesis를 reject 하게 된다. 곧 이 차이는 유의하다고 판단하게 된다.

http://www.enviroliteracy.org/pdf/materials/1210.pdf : chi-square 설명
http://acb.qfab.org/acb/ws09/presentations/Day3_JStankovich.pdf : chi-square, odd ratio 설명

Friday, April 27, 2012

Using Excel for Bioinformatics Data: Five Issues, Five Solutions

아래 링크는 5AM이라는 bioinformatics 회사에서 제공한 white paper로 생물학자들이 데이터를 분석하는데  excel을 많이 애용하는데, 이때 주의해야 할 점을 요약해 놓았다.


http://info.5amsolutions.com/bid/120220/Using-Excel-for-Bioinformatics-Data-Five-Issues-Five-Solutions


1. Manipulation of Gene Symbols

  • issue : 사용자가 넣어주는 데이터를 보고 excel이 알아서 formatting 을 한다는것. 예를 들어 SEP5 나 DEC-2 같은 경우 excel이 날짜 데이터로 인식하고 5-SEP, 2-DEC로 변경한다.
  • solution : 
    1. excel로 파일을 import 하기 전에 파일을 처리 할 수 있다면 gene symbol에 space나 apostrophe ( ' ) 를 넣어서 excel이 text 로 인식하게끔 한다.
    2. import wizard (그러니까 데이터를 import 할때 뜨는 팝업창 같은거) 에서 컬럼 서식을 "general" 대신 "text" 로 변경해준다.
2. The Incomplete Sort
  • issue : excel sheet의 일부 컬럼만 영역으로 선택해서 sorting 하게 되면 가끔 spreadsheet corruption 이 일어난다. 특히나 컬럼을 hidden 했을땐 이런 일이 종종 일어난다. 물론 대부분 excel이 컬럼 영역을 확장할 것인가를 물어보지만 물어보지 않을때도 있다.
  • solution : spread sheet 의 왼쪽 상단을 눌러서 전체 영역을 선택하는 습관을 가져라
3. Hidden Characters
  • issue : 웹에서 혹은 문서에서 특정 영역을 카피해다가 excel에 paste 하면 hidden character가 딸려 들어가서 특정 formula를 사용해서 에러가 날 때 까지 인지를 못할 경우가 발생
  • solution : excel이 TRIM and CLEAN data를 위한 formulas를 제공한다. 아니면 notepad 같은 걸로 거쳐서 거기서 다시 copy해서 excel로 옮기면 된다.
4. Information Through Formats
  • 이건은 생략한다. 딱히 뭐가 문젠지.. 굳이 이야기 하자면 글자색같은 format으로 정보를 넣으면 나중에 sorting  할때 혹은 그냥 text로 저장할때 그 색깔에 넣은 정보가 고스란히 날라간다는 문제점을 이야기 하는건데.. 주의하자는 거다.
5. Mistaken SYLK Files
  • issue : excel에서 text 파일의 첫 두 문자가 ID 이면 자동으로 SYLK(symbolic link 파일) 로 인식해서 에러 메시지를 낸다.
  • solution : ID 대문자를 id 소문자로 변환해도 이런 에러를 피할수 있으며 혹은 apostrophe 를 붙이거나 아니면 그 컬럼의 위치를 다른 곳으로 바꾼다.

Wednesday, April 4, 2012

python extension

tabix 를 python으로 importing 하기 위한 장혜식님의 c 코드를 이해하기 위해 필요한 것들을 정리 해본다.

일단 compiled language 로 작성된 code를 python에서 import 하기 위해선 "extension" 시켜야 하는데 이에 대한 기본적인 내용은 아래 사이트에서 찾아볼 수 있다.

<python - Further Extension using C>


<.so 와 .dll>
한빛 미디어에서 나온 유닉스,리눅스 프로그래밍 필수 유틸리티 gcc 부분 참조